
Red teaming IA : testez la résistance de vos agents avant qu'on ne l'éprouve
Sachez ce qu'un attaquant peut faire faire à vos agents d'IA, et comment l'en empêcher.
- Conformité, sécurité & éthique IA
- 2 750 – 6 600 € HT
- Réalisation : 5 à 12 jours
- Délai : 3 à 5 semaines
- Forfait
Ce que fait ce service
Le périmètre, en clair.
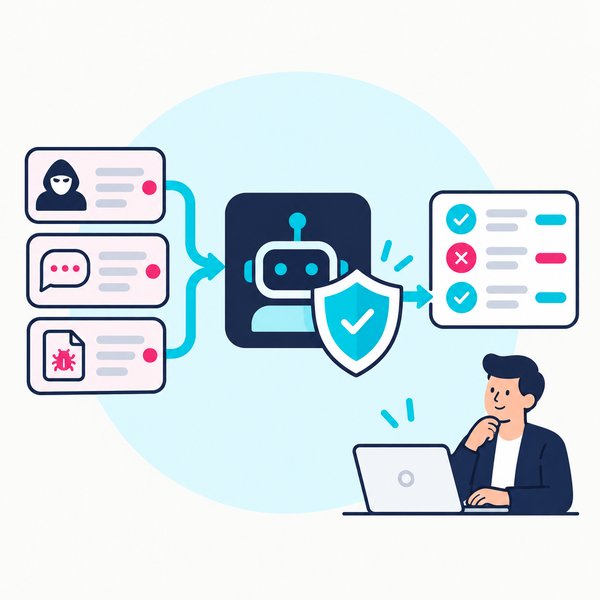
Un agent qui lit vos e-mails, consulte votre CRM et peut répondre à votre place est une cible : il suffit parfois d'un message piégé pour lui faire faire autre chose. Notre red teaming IA joue le rôle de l'attaquant, avec votre accord écrit et sur un environnement de test : détournement des consignes, instructions cachées dans un e-mail ou un PDF, abus des outils connectés, extraction de données, escalade de droits. Vous recevez un journal de scénarios rejouables, un classement des faiblesses et des mesures de durcissement, puis un contre-test pour vérifier les corrections.
Un agent d'IA ne se contente pas de répondre : il lit des contenus qu'il ne maîtrise pas, il appelle des outils, il écrit dans vos systèmes. Un attaquant n'a pas besoin de pirater un serveur, il lui suffit de glisser une instruction dans un document, un e-mail ou une page que l'agent va lire. Le red teaming IA consiste à imaginer et exécuter ces attaques de façon contrôlée, avant qu'elles ne surviennent. Les entreprises le demandent quand leurs agents ont des droits d'écriture ou accèdent à des données sensibles, quand elles passent d'un chatbot d'information à un agent qui agit, ou quand un client exige des preuves de robustesse. Le résultat est très concret : des scénarios documentés, la liste de ce qui a fonctionné, et des mesures de limitation des droits, de validation humaine et de filtrage. Ce service se distingue de l'audit de sécurité, qui revoit la conception et la configuration : ici, on attaque réellement, mais dans un cadre autorisé et délimité. Aucune attaque n'est lancée sans accord écrit, aucune donnée réelle n'est exfiltrée, et le résultat ne vaut ni certification ni garantie d'invulnérabilité.
Méthodologie
5 à 12 jours · 3 à 5 semaines
Étape 1 – Règles du jeu (1 jour)
périmètre, environnement de test, scénarios exclus, canal d'alerte et accord écrit signé avant tout essai.
Étape 2 – Modélisation des menaces (1 jour)
cartographie des entrées de l'agent, de ses outils et des dégâts possibles pour chacun.
Étape 3 – Campagne d'attaques (4 jours)
détournement de consignes, injections indirectes par e-mail ou document, abus d'outils, extraction de données, boucles de coûts.
Étape 4 – Analyse et durcissement (2 jours)
classement des faiblesses, limitation des droits, validations humaines, filtres, avec recommandations chiffrées.
Étape 5 – Contre-test (2 jours)
rejeu des scénarios sur la version corrigée et remise du jeu de tests pour vos futures évolutions.
Points forts
Ce qui distingue cette prestation.
- Les attaques indirectes, cachées dans des e-mails ou des documents, sont testées, car c'est la voie la plus réaliste.
- Le jeu de scénarios est remis et rejouable : il devient un test de non-régression à chaque changement.
- Le périmètre et les interdits sont signés avant le premier essai, qui reste cantonné à un banc d'essai séparé.
- Les mesures proposées privilégient la limitation des droits de l'agent plutôt que l'empilement de filtres.
- Un contre-test vérifie que les corrections tiennent, pas seulement qu'elles ont été déployées.
Livrables remis
Ce que vous gardez à la fin.
- Document de règles du jeu signé
- Modèle de menaces de l'agent
- Journal des scénarios d'attaque avec résultats
- Rapport de faiblesses priorisé
- Rapport de faiblesses et plan de durcissement chiffré
- Jeu de tests rejouable et rapport de contre-test
Problèmes résolus
Les situations où ce service sert.
- Nous craignons qu'un e-mail piégé fasse agir notre agent contre nous
- Nous ne savons pas jusqu'où notre agent peut aller avec ses droits actuels
- Nous n'avons aucun test pour vérifier la robustesse après chaque évolution
Cas d’usage
Exemples illustratifs, sans client nommé.
Société de négoce de 90 personnes avec un agent qui répond aux e-mails fournisseurs et met à jour son ERP : la campagne montre qu'un e-mail piégé peut modifier une coordonnée bancaire, ce qui impose une validation humaine.
Cabinet de conseil de 45 personnes avec un assistant interne qui lit les dossiers clients : la campagne teste ses droits de lecture et vérifie qu'une consigne cachée ne lui fait pas dépasser son périmètre.
Éditeur de logiciel de 60 personnes dont l'agent de support accède à l'historique des tickets : il est éprouvé contre les fuites d'informations entre clients et contre les réponses hors cadre.
Pour qui, et dans quelles conditions
Public, tailles, secteurs et prérequis.
- Public visé
- RSSI · DSI · Directeur technique · Responsable de produit IA
- Tailles d’entreprise
- PME · ETI
- Secteurs adaptés
- Négoce et distribution · Éditeurs de logiciels · Banque et assurance · Conseil · Services aux entreprises
- Prérequis
- Un agent ou un chatbot fonctionnel, avec un environnement de test · Accord écrit de la direction sur le périmètre des essais · Un interlocuteur technique pour traiter les alertes
Technologies mobilisées
Les outils cités à titre indicatif : le choix se confirme au cadrage.
- Python
- Garak
- PyRIT
- Promptfoo
- LangChain
- Docker
- Mistral
- OpenAI
Retour sur investissement
Indicatif — le chiffrage se confirme sur vos volumes.
Souvent, une faiblesse trouvée en test se corrige en quelques jours, alors qu'une action non voulue d'un agent en production peut coûter un paiement erroné ou une fuite. L'enjeu croît avec les droits de l'agent, à valider lors du diagnostic.
Questions fréquentes
Les réponses courtes.
Qu'est-ce que le red teaming appliqué à une IA ?
C'est un exercice où des spécialistes jouent le rôle d'attaquants pour pousser un chatbot ou un agent à sortir de son cadre : révéler des données, contourner des règles, déclencher des actions non voulues. Les résultats servent à corriger avant qu'un véritable attaquant n'exploite ces failles.
Mes données réelles sont-elles exposées pendant ces essais ?
Non, sauf accord écrit explicite. Tout se passe sur un banc d'essai isolé, alimenté de données fictives ou anonymisées. Les règles du jeu fixent ce qui est autorisé, ce qui est exclu et la manière de nous arrêter immédiatement en cas de doute.
Quand faut-il un red teaming plutôt qu'un simple audit de sécurité ?
Dès que l'agent peut agir : envoyer des messages, modifier des enregistrements, déclencher des paiements ou accéder à des données sensibles. Pour un chatbot en lecture seule, l'audit suffit souvent. Pour un agent doté de droits, le red teaming révèle les enchaînements d'attaque que la revue ne voit pas.
Tester mes agents d'IA
2 750 – 6 600 € HT · 5 à 12 jours — diagnostic de 45 minutes offert pour vérifier le périmètre. Devis ferme ensuite.