
Extraction de données OCR : vos scans et PDF en champs exploitables
Vos documents papier et PDF deviennent des données prêtes à entrer dans vos outils.
- Automatisation des processus
- 2 750 – 4 950 € HT
- Réalisation : 5 à 9 jours
- Délai : 3 à 5 semaines
- Forfait
Ce que fait ce service
Le périmètre, en clair.
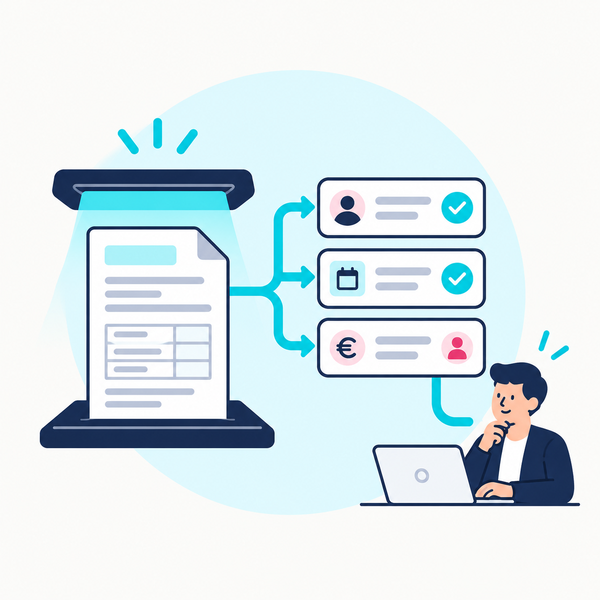
Un OCR classique reconnaît des lettres ; l'extraction de données OCR assistée par IA comprend où se trouve le numéro de commande, la date de livraison ou le montant TTC, même quand la mise en page change d'un émetteur à l'autre. Ce service branche cette lecture sur vos documents répétitifs : bons de livraison, relevés, attestations, fiches de pesée, formulaires. Chaque champ extrait reçoit un score de confiance, les valeurs douteuses vont à un relecteur, le reste alimente directement votre ERP, votre tableur ou votre GED. Mise en place en 5 à 9 jours.
Courriels, scans de l'imprimante, photos prises sur un chantier, PDF de portails : les documents arrivent par tous les canaux et chaque service les ressaisit à sa façon. Pour les formulaires fixes, l'extraction de données OCR est mûre depuis longtemps, mais elle butait sur les documents à mise en page variable. Les modèles de langage et de vision changent la donne : on décrit les champs voulus, le système les cherche et renvoie une sortie structurée au format JSON ou CSV, avec un indice de fiabilité. Le travail du projet consiste à choisir les bons documents, à définir précisément chaque champ (que veut-on dire par date : émission, livraison, échéance ?), à mesurer la précision sur un jeu de test annoté, puis à brancher la sortie vers l'outil qui en a besoin. Ce que le service n'est pas : un moteur de lecture universel qui promet 100 % de réussite, ni un service d'archivage. Pour la classification de courriers ou l'indexation de fonds anciens, d'autres services existent. Quand les documents contiennent des données personnelles, comme des RIB ou des pièces d'identité, le traitement se fait en Europe, avec durée de conservation limitée et accès restreint, conformément au RGPD.
Méthodologie
5 à 9 jours · 3 à 5 semaines
Étape 1 – Choix des documents (0,5 jour)
tri de 200 documents réels par type et par émetteur, choix des familles à traiter en premier, définition précise de chaque champ à lire.
Étape 2 – Jeu de test annoté (1 jour)
constitution d'un échantillon de référence corrigé à la main, qui servira à mesurer la précision avant et après chaque réglage.
Étape 3 – Lecture et extraction (3 jours)
prétraitement des scans et photos, lecture par OCR, extraction des champs par modèle de langage, tableaux de lignes, score de confiance par valeur.
Étape 4 – Relecture et sortie (2 jours)
interface de correction pour les champs douteux, contrôles de cohérence (somme des lignes, format de date), export vers votre ERP, GED ou tableur.
Étape 5 – Mesure et transfert (1,5 jour)
rapport de précision par champ, seuils de relecture, consignes de maintenance quand un nouvel émetteur apparaît.
Points forts
Ce qui distingue cette prestation.
- Précision mesurée champ par champ sur un échantillon annoté de vos propres documents, avec rapport avant et après chaque réglage.
- Lecture des lignes de tableau (articles, quantités, prix) et pas seulement des en-têtes, souvent le point faible des OCR classiques.
- Score de confiance sur chaque valeur extraite, avec interface de relecture limitée aux champs en dessous du seuil retenu.
- Sortie structurée en JSON ou CSV, prête à être injectée dans un ERP, une GED, un tableur ou un autre automate.
- Traitement des photos de mobile et des scans de travers, courants sur les chantiers, les quais de livraison et les tournées.
Livrables remis
Ce que vous gardez à la fin.
- Pipeline de lecture et d'extraction paramétré
- Jeu de test annoté et rapport de précision
- Interface de relecture des champs douteux
- Export structuré vers vos outils
- Documentation des champs et des règles de contrôle
- Session de formation des relecteurs
Problèmes résolus
Les situations où ce service sert.
- Des documents ressaisis à la main dans plusieurs outils
- Des erreurs de recopie sur les références et les montants
- Des pièces papier et PDF inexploitables dans les recherches
- Une dépendance à quelques personnes qui connaissent les documents
Cas d’usage
Exemples illustratifs, sans client nommé.
Négociant en matériaux recevant des bons de livraison photographiés par ses chauffeurs : les quantités sont extraites et comparées aux commandes, seules les anomalies passent en revue.
Cabinet de comptabilité recevant des justificatifs variés de ses clients : relevés, attestations et RIB sont lus et rangés, les champs sensibles étant contrôlés par un collaborateur.
Atelier industriel produisant des certificats matière et fiches de contrôle en PDF : les valeurs clés alimentent un tableau de suivi qualité interrogeable sans ouvrir chaque fichier.
Pour qui, et dans quelles conditions
Public, tailles, secteurs et prérequis.
- Public visé
- Responsable des opérations · DAF · DSI · Responsable qualité
- Tailles d’entreprise
- PME · ETI
- Secteurs adaptés
- Négoce · Logistique · Industrie · Cabinets comptables · Assurance
- Prérequis
- Un échantillon d'au moins 200 documents réels par famille prioritaire · Définition des champs attendus avec un utilisateur métier · Accord sur le lieu de stockage et la durée de conservation des documents
Technologies mobilisées
Les outils cités à titre indicatif : le choix se confirme au cadrage.
- Python
- Azure Document Intelligence
- Mistral
- Claude
- Gemini
- Tesseract
- n8n
- Make
Retour sur investissement
Indicatif — le chiffrage se confirme sur vos volumes.
La ressaisie d'un document de quelques lignes occupe souvent plusieurs minutes, alors que la revue des seuls champs douteux se compte en secondes. Selon vos volumes et la qualité des originaux, le gain se mesure en jours par mois, avec moins d'erreurs de recopie.
Questions fréquentes
Les réponses courtes.
Quelle différence entre un OCR classique et une extraction avec IA ?
L'OCR classique transforme l'image en texte brut. L'IA va plus loin : elle repère les champs utiles, comprend les tableaux et s'adapte aux mises en page changeantes. Elle fournit donc une donnée prête à utiliser, avec un indice de confiance, et non un bloc de texte à retraiter.
Peut-on lire des documents manuscrits ou des photos prises sur le terrain ?
Oui dans une certaine mesure. Les photos nettes de documents imprimés donnent de bons résultats ; l'écriture manuscrite est moins fiable et exige davantage de relecture. Nous mesurons la précision sur vos propres exemples avant d'engager le déploiement, et nous décidons ensemble des familles à traiter.
Mes documents contenant des données personnelles peuvent-ils être traités sans risque ?
Oui, avec des précautions : hébergement dans l'UE, accès restreint, durée de conservation définie et choix de modèles qui n'utilisent pas vos données pour s'entraîner. Pour les pièces les plus sensibles, un modèle hébergé chez vous ou en France peut être retenu.
Lisez vos documents automatiquement
2 750 – 4 950 € HT · 5 à 9 jours — diagnostic de 45 minutes offert pour vérifier le périmètre. Devis ferme ensuite.