
GED augmentée par IA : vos documents classés et indexés sans saisie
Déposez un document : il est nommé, classé, indexé et retrouvable sans que personne ne remplisse de champs.
- IA documentaire & gestion des connaissances
- 5 500 – 9 900 € HT
- Réalisation : 10 à 18 jours
- Délai : 6 à 10 semaines
- Forfait
Ce que fait ce service
Le périmètre, en clair.
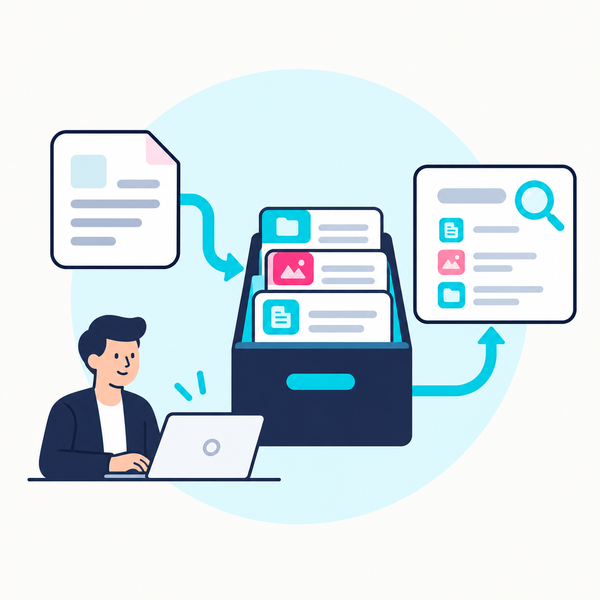
La GED augmentée par IA ajoute de l'intelligence à la gestion électronique de documents que vous utilisez déjà. À chaque dépôt, elle lit le document, reconnaît son type, renseigne les métadonnées (tiers, date, référence, montant), le nomme selon vos règles et le range dans le bon espace. Les cas douteux partent dans une file de contrôle. Nous traitons aussi le stock existant : détection des doublons, renommage en masse, reprise des documents sans métadonnées. Le service est pensé pour les structures où la saisie des champs décourage les utilisateurs.
Une GED vaut ce que valent ses métadonnées. Quand les utilisateurs doivent saisir six champs à chaque dépôt, ils n'en remplissent que deux, et le plan de classement se dégrade en quelques mois : fichiers nommés « scan_final2 », doublons, dossiers fourre-tout. Les entreprises demandent une GED augmentée par IA pour sortir de ce cercle sans changer de logiciel ni migrer des millions de fichiers. Au quotidien, l'utilisateur dépose, l'outil propose, et seuls les cas incertains sont soumis à un humain, avec un seuil de confiance réglable. Ce n'est pas un nouveau logiciel de GED, ni un projet d'archivage légal : les durées de conservation relèvent de votre politique d'archivage, que nous appliquons si elle existe. Nous démarrons sur un périmètre limité, par exemple les dossiers fournisseurs ou salariés, mesurons le taux de classement correct, puis étendons. Les droits d'accès de votre GED sont conservés, et tout reclassement est tracé et réversible.
Méthodologie
10 à 18 jours · 6 à 10 semaines
Étape 1 – Audit du plan de classement (2 jours)
analyse de l'arborescence, des métadonnées utilisées, des règles de nommage et des zones où la GED est contournée.
Étape 2 – Règles et modèle cible (2 jours)
plan de classement simplifié, liste des métadonnées utiles, règles de nommage, politique de conservation applicable.
Étape 3 – Moteur de reconnaissance (4 jours)
identification des types de documents, extraction des métadonnées, calcul d'un score de confiance, premiers essais sur 500 documents.
Étape 4 – Intégration à la GED (3 jours)
branchement par API, classement à l'arrivée, file de contrôle, journal de chaque décision.
Étape 5 – Reprise du stock (3 jours)
traitement par lots, dédoublonnage, validation d'échantillons, mesure du taux de classement correct, bilan.
Points forts
Ce qui distingue cette prestation.
- L'outil se branche sur votre GED actuelle par API, sans migration ni changement d'outil pour les utilisateurs
- Un score de confiance décide ce qui est classé seul et ce qui passe en file de contrôle
- Le journal indique la raison de chaque classement, et chaque reclassement peut être annulé
- Le stock existant est traité par lots, avec dédoublonnage et validation d'échantillons par vos équipes
- Les règles de conservation de votre politique d'archivage sont appliquées aux types de documents reconnus
Livrables remis
Ce que vous gardez à la fin.
- Plan de classement et règles de nommage cibles
- Moteur de reconnaissance branché à la GED
- File de contrôle avec seuil de confiance réglable
- Journal des décisions de classement
- Rapport de reprise du stock avec taux de réussite
- Formation de l'administrateur de la GED
Problèmes résolus
Les situations où ce service sert.
- Personne ne remplit les métadonnées à chaque dépôt
- Notre GED est pleine de doublons et de fichiers mal nommés
- Retrouver un document demande de connaître l'arborescence
- Les règles de conservation ne sont pas appliquées au stock
Cas d’usage
Exemples illustratifs, sans client nommé.
Entreprise d'assurance de 180 salariés : les documents de dossiers clients sont typés et indexés à l'arrivée, et la file de contrôle ne reçoit que les cas douteux.
Cabinet notarial de 25 personnes : actes, pièces d'identité et justificatifs sont rangés dans le dossier du client avec des noms homogènes.
Industriel de 300 salariés : le stock de 400 000 fichiers est dédoublonné et renommé par lots sur un périmètre pilote.
Pour qui, et dans quelles conditions
Public, tailles, secteurs et prérequis.
- Public visé
- Responsable GED ou archives · DSI · DAF · Responsable administratif
- Tailles d’entreprise
- PME · ETI
- Secteurs adaptés
- Assurance · Notariat · Industrie · Immobilier · Collectivités
- Prérequis
- GED existante avec accès par API ou export · Plan de classement ou arborescence actuelle · Un administrateur GED disponible
Technologies mobilisées
Les outils cités à titre indicatif : le choix se confirme au cadrage.
- Python
- Azure Document Intelligence
- Mistral
- OpenSearch
- PostgreSQL
- n8n
- API REST
- Claude
Retour sur investissement
Indicatif — le chiffrage se confirme sur vos volumes.
Si la saisie de métadonnées prend deux minutes par document et que 100 documents arrivent chaque jour, une automatisation à 80 % libère de l'ordre de trois heures quotidiennes, sans compter le temps de recherche économisé. À valider.
Questions fréquentes
Les réponses courtes.
Faut-il changer de GED pour la rendre augmentée par IA ?
Non dans la plupart des cas. Nous nous connectons à votre GED actuelle par API ou par export, et les utilisateurs gardent leur interface. Si votre outil est trop fermé pour cela, nous le disons dès l'audit du plan de classement.
Quel taux de classement automatique peut-on espérer ?
Cela dépend de la variété des documents. Sur des types bien identifiables, le taux atteint souvent une large majorité des dépôts, les cas restants passant par la file de contrôle. Nous mesurons le chiffre exact sur vos documents avant de généraliser.
Que devient le stock de documents déjà mal rangés ?
Il est traité par lots : détection des doublons, reconnaissance du type, renseignement des métadonnées et renommage. Chaque lot est validé sur un échantillon par vos équipes, et tout changement est tracé et réversible, ce qui limite le risque d'un reclassement erroné.
Auditer ma GED existante
5 500 – 9 900 € HT · 10 à 18 jours — diagnostic de 45 minutes offert pour vérifier le périmètre. Devis ferme ensuite.